整音した2時間の対談を、話者別字幕・無音カット・章付きのYouTube動画にする:whisper.cpp・ローカルLLM・Pythonで組んだ仕上げの工程
シリーズ: 遠隔収録の整音からYouTube公開まで(後編)
前編: 遠隔収録で相手トラックに混入した自分の声(クロストーク)を消す
前編では、遠隔収録の相手トラックに混入していた自分の声を、時間合わせした参照とDe-bleedで消すまでを書きました。後編はその続きです。整音した約130分の対談を、話者ごとに左右に分かれた字幕・無音カット・章の見出し付きのYouTube動画にするまでをまとめます。
文字起こしから動画の書き出しまで、すべてMac上のツールとローカルのモデルで回しています。人の手が入ったのは、LLMが出した固有名詞の修正案を読んで採否を決めるところと、見本を見て見た目を決めるところだけです。
完成した動画
聴き比べ用に、クロストークが残ったままの旧版も置いておきます(2025年公開)。相手が話していないところで、私の声が遠くに聞こえます。
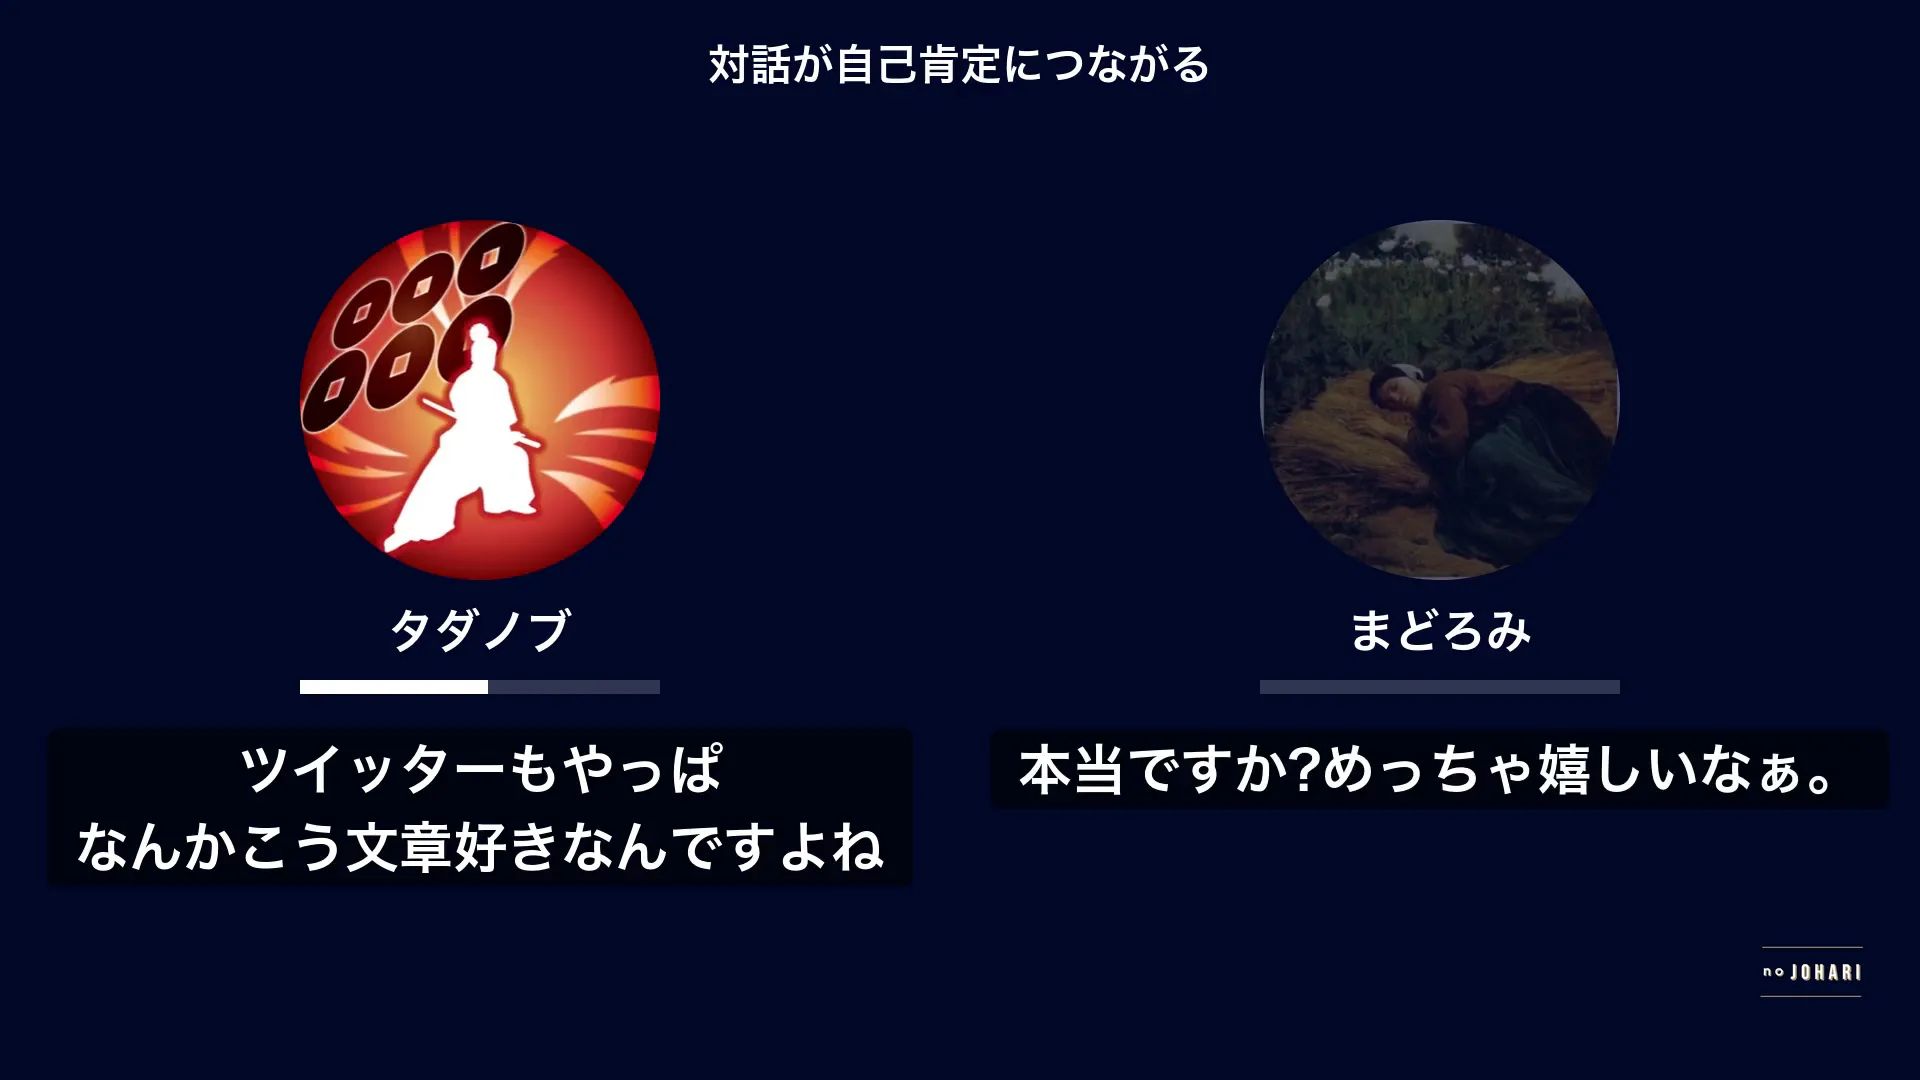
画面の左右に2人のアイコンと音量バーを置き、話している人の字幕を、その人のアイコンの下に出しています。話していない側は少し暗くなります。
全体の流れ
仕上げの合成
前編の整音を終えた2本のトラックを、1本の音声に合成します。ここで気をつけたのは、2本の時間のずれです。
前編で書いたとおり、相手トラックに届いた私の声は、収録中に483回、小さく前後に跳んでいました。これは相手側から見ると「私の声がいつ聞こえていたか」の記録でもあります。そのまま合成すると、会話の間や被り方が、相手が実際に聞いていたものとずれます。
そこで、相手トラックを区間ごとに一定量ずらし、相手が実際に聞いていた位置に揃えました。切り替えは482か所あります。切り替えの位置で音を継ぐと声が二重になったり欠けたりするので、近くの相手が黙っている所(前後3秒以内)へ継ぎ目を寄せ、15 msのクロスフェードでつないでいます。寄せた後は、継ぎ目が相手の声にかかる所はありませんでした。
ほかに、相手トラックだけに軽いディエッサー、両方に2:1のコンプレッサーをかけ、全体を −16 LUFS(ピーク −1 dBTP)に揃えています。
トラック別に文字起こしする
文字起こしには、whisper.cppとlarge-v3-turboモデルを使いました。合成した130分の音声なら、5分ほどで終わります。
ただ、合成した音声から起こすと、誰の発言かを後から推定しなければなりません。今回は2人のトラックが別々にあるので、トラックごとに起こせば、話者は最初から分かります。
ここで1つつまずきました。聞き手の私のトラックは、大半が無音です。そのままwhisperにかけると、字のタイムスタンプが無音をまたいで間延びし、語が途中で切れたり、同じ文が13回繰り返される「空回り」が出たりしました。
対策は、話している所だけを詰めた音声を作ってから起こすことです。発話区間の間の無音を0.4秒に縮めてwhisperにかけ、出てきた時刻を元の時間軸に戻します。時刻のずれで捨てるしかなかったフレーズは、私のトラックで747→166、相手のトラックで493→79まで減りました。
字幕を文節の頭で切り直す
whisperが返すフレーズは長さがまちまちで、そのまま字幕にすると、1枚に2人の発言が混ざったり、文の途中で次の字幕に替わったりします。
句読点と、字の時刻の空き(0.4秒以上)で切り直しました。ただ、whisperの字の時刻は1〜2字ぶん前後するので、空きの位置でそのまま切ると「だいぶお誘 / いしてから」のように語の途中で切れます。そこで、形態素解析(janome)で文節の頭を探し、前後3字以内のいちばん近い文節の頭へ切れ目を寄せるようにしました。
結果は次のとおりです。
- 文の途中で字幕が替わる所: 611 → 216
- 相づちが別の人の発言と同じ1枚に入る所: 170 → 1
固有名詞は、LLMに候補を出させて人が読む
whisperは、固有名詞や専門用語をよく聞き違えます。ローカルのLLMに、字幕を10分ずつ(前後1分の文脈つき)見せて、修正の候補を出させました。
候補は102件出ました。これをそのまま当てることはしませんでした。読んでみると、LLMが「確信が高い」とした60件のうち23件は、当ててはいけないものでした。
- 推測での言い換え(聞き違いを、別のもっともらしい語に置き換えている)
- 会話の中の呼び名(あだ名)を、正式な名字に直してしまう
- 本の著者名を、別の誤りに置き換える
逆に、LLMが「自信がない」とした候補の中に、明らかな同音の取り違え(伝家の宝刀、拍子抜け、期せずして)がありました。
なので、LLMは候補を出すだけにして、採否はすべて人が読んで決め、「当てない」「当てるが迷った」も記録に残す形にしました。最終的に当てた修正は78件です。文脈から正しい語が決まらないものは、直さずに残しています。
無音カットと1.05倍速
130分をそのまま流すと長いので、間を詰めました。
最初は、区間分類で「どちらも話していない」所を1.2秒を超えたら0.6秒に詰める、という単純な規則にしました。これだと174か所・200秒が抜けます。ところが、抜く範囲の中に、話し声のレベルのフレームが含まれていて、字幕148枚ぶんの声を切っていました。区間分類が「話していない」と判断していても、相づちや小さな声が実際には入っていたわけです。
そこで「両方のトラックとも、話し声のレベルより30 dB以上小さい」という条件を足しました。抜けるのは54か所・56秒に減りましたが、声にはかかりません。
さらに全体を1.05倍速にして、130分31秒 → 123分25秒になりました。1.1倍と聴き比べて、1.05倍を選んでいます。
動画の描画は、Pythonでフレームを組む
字幕を焼き込むなら、ffmpegの字幕フィルタを使うのが定番です。ところが、MacにHomebrewで入れたffmpegは、字幕の描画に要るライブラリ(libass)が入っていない構成でした。文字が描けません。
入れ直す手もありましたが、今回はPythonで1コマずつ絵を組んで、ffmpegの標準入力に流し込む形にしました。Pillowで文字やアイコンを描き、numpyで画像を組み、無圧縮の映像としてffmpegに渡して、ffmpegには圧縮だけさせます。
この形にすると、見た目を自由に作れます。
- 話者ごとのアイコンと音量バー。バーの範囲は話し声のレベルで −40〜+14 dBにしました。上端を +6 dBにすると、話している時間の2割前後で振り切れてしまうためです
- 字幕は、話している人のアイコンの下に出す。同時に話している所では、左右に同時に出ます
- 話していない側を暗くする
- 章が替わる所で見出しを出す
- 冒頭3秒にタイトル、末尾2秒に暗転。どちらも音声の長さの中に収め、動画の長さが音声とずれないようにしました
速くするコツは、絵が変わらないコマでは前のコマをそのまま送ることです。123分・30 fpsの描画が約9分、音声との結合が約2分で終わりました。
章立てとタイトル
章の区切り(11か所)、タイトル案、概要欄の下書きも、文字起こしをローカルのLLMに読ませて作りました。ここも最終的には人が読んで選んでいます。
まとめ:収録システムの後段にそのまま入る
前編・後編を通して作った工程は、次のとおりです。
- 2トラックの時間合わせ(揺らぎ込み)
- De-bleed(自前実装)で、混入した自分の声を消す
- RXのプラグインで整音(pedalboardでヘッドレス)
- 2トラックの合成
- トラック別の文字起こし、字幕の切り直し
- 固有名詞の修正(LLMの候補を人が読む)
- 無音カット・速度・動画の描画
人の判断が要るのは6だけで、ほかは次の収録からはコマンドで回せます。
いま、Riverside.fmのような1対1の収録システムを自分で作れないか考えています。参加者ごとに別のファイルで録音し、ホストの側から相手の設定を見て変えられるものです。この工程は、その収録システムの後段にそのまま入ります。収録が終わったら、整音された音声と字幕付きの動画ができあがっている。そこまで持っていくのが次の目標です。